

旧电脑跑DeepSeek最强模型!速度起飞!
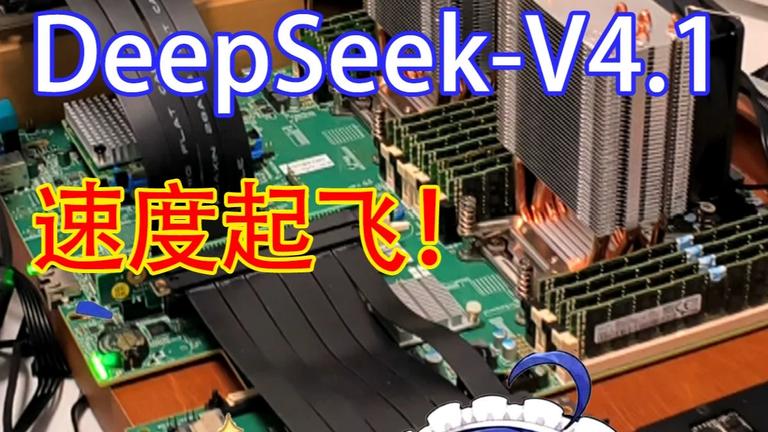
一台老旧的 DDR3 服务器,竟然成功运行了几百 GB 的 DeepSeek 大模型!双显卡实测生成速度达到 33.5 Token/s。 这次我使用二手服务器硬件,从零搭建了一台 512GB 内存的本地 AI 服务器,尝试在普通人也能接触到的旧硬件上运行 DeepSeek-V4.1-Flash-1017。 整个过程并不顺利。从服务器主板、CPU、DDR3 内存的安装,到 Tesla V100 显卡的配置,再到 Strata 推理框架的部署,中间遇到了不少意想不到的问题。 最初模型运行速度只有个位数 Token/s。经过排查和优化,最终实现了: 单张 NVIDIA Tesla V100:约 19 Token/s 双张 NVIDIA Tesla V100:最高实测约 33.5 Token/s 256K 上下文长度测试 成功运行超过 400GB 的 IQ3_S 量化模型,生成速度约 16.7 Token/s 这次测试也让我发现,运行大型 AI 模型并不一定需要最新、最昂贵的硬件。通过合理利用服务器内存、二手显卡和分层推理技术,也能让普通人以相对低成本体验本地运行大型语言模型。 本期硬件配置: 主板:Inventec B600GG1-10G CPU:Intel Xeon E5-2698B v3 × 2 内存:512GB DDR3 ECC RDIMM 显卡:NVIDIA Tesla V100 × 2 推理框架:Strata 模型:DeepSeek-V4.1-Flash-1017 系统:Ubuntu Linux 本期涉及技术与关键词: DeepSeek 本地部署、DeepSeek V4.1 Flash、AI 大模型本地运行、512GB DDR3 服务器、Tesla V100 双显卡、GPU 推理、CPU 内存推理、MoE 混合专家模型、GGUF 量化、IQ2_XS、IQ3_S、Strata 推理框架、256K Context。 这只是这个低成本 AI 服务器项目的开始。接下来还会继续研究双显卡协同、专家并行、张量并行以及更高效的大模型推理方案。 如果你也喜欢本地 AI、大模型部署、旧电脑改造和服务器硬件折腾,欢迎订阅关注!#deepseek #大肥鱼#本地AI #本地部署